В CMS тысячи страниц. Но какие из них Google вообще знает и считает нужными для поиска?
Разбираем путь карточки товара от создания в магазине до индекса Google и определяем, где именно могут потеряться важные URL.
СНАЧАЛА – НЕ КОЛИЧЕСТВО, А СОСТАВ
30 000 URL в магазине не означают, что все 30 000 должны находиться в индексе
Каталог может содержать товары, категории, бренды, SEO-фильтры, сортировки, параметры, страницы поиска и технические комбинации. Для Google эти URL имеют разную ценность.
ДОЛЖНЫ РАБОТАТЬ В ПОИСКЕ
Категории, товары, бренды и выбранные коммерческие фильтры
То есть канонические страницы, способные отвечать на самостоятельный поисковый спрос.
НЕОБЯЗАТЕЛЬНО ИНДЕКСИРОВАТЬ
Сортировки, параметры, дубли и технические комбинации
Сам факт существования URL ещё не делает его полезной поисковой страницей.
ГДЕ ПОТЕРЯЛАСЬ СТРАНИЦА
Между CMS и индексом Google находится несколько разных этапов
Если не определить конкретный этап потери, можно месяцами исправлять совсем не ту проблему.
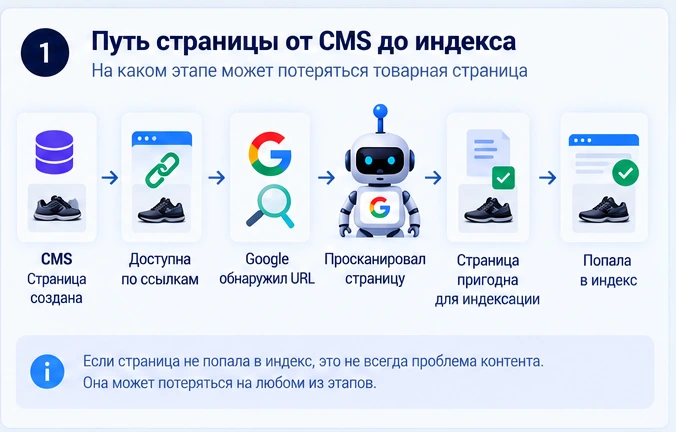
Страница создана в CMS
URL физически существует.
Google может обнаружить URL
Есть ссылка, sitemap или другой путь обнаружения.
URL обнаружен
Google уже знает адрес страницы.
Страница просканирована
Googlebot получил содержимое URL.
Определён canonical
Выбрана основная версия страницы.
URL находится в индексе
Теперь страница вообще может участвовать в поиске.
СЦЕНАРИЙ 1 · GOOGLE НЕ ЗНАЕТ URL
В CMS 10 000 товаров, а Google обнаружил только 7 000
В такой ситуации пока бессмысленно переписывать описания остальных карточек. Сначала нужно понять, каким способом поисковик вообще должен был узнать об их существовании.
ВНУТРЕННИЕ ССЫЛКИ
Можно ли дойти до товара из обычного каталога?
Главная → категория → подкатегория → карточка товара.
SITEMAP
Передаёт ли карта сайта нужный URL?
Если коммерчески важной страницы нет даже там, сначала проверяем сам сайт.
СИРОТСКИЕ СТРАНИЦЫ
URL существует, но почти ниоткуда не связан с каталогом
Часто появляется после импорта товаров, миграции или перестройки категорий.
КАТАЛОГ ДОЛЖЕН БЫТЬ ДОСТУПЕН РОБОТУ
«Показать ещё», фильтры и JavaScript могут визуально работать – но плохо раскрывать каталог Google
Пользователь нажимает кнопку и видит следующие товары. Но поисковый робот не обязан повторять человеческие действия.
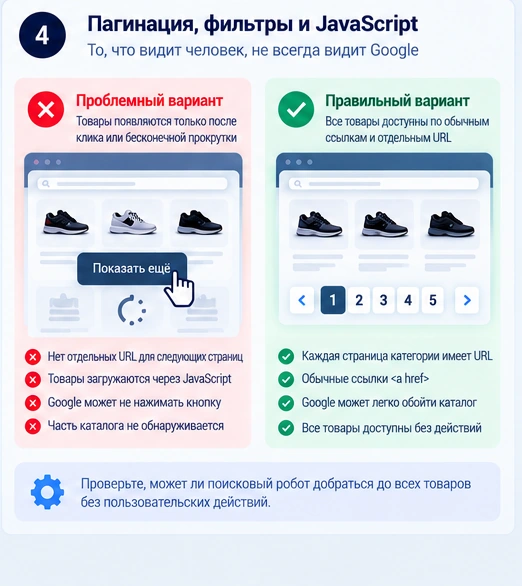
Товары появляются только после кнопки или бесконечной прокрутки
Следующие страницы имеют собственные URL и доступны обычными ссылками
СЦЕНАРИЙ 2
Что означает «Обнаружена, не проиндексирована»
Google уже знает URL, но пока его не просканировал. Поэтому из одного этого статуса нельзя делать вывод, что содержимое страницы было признано слабым.
СМОТРИМ НЕ ОДНУ СТРАНИЦУ, А ЗАКОНОМЕРНОСТЬ
НЕ ПРЕВРАЩАЙТЕ CRAWL BUDGET В УНИВЕРСАЛЬНОЕ ОБЪЯСНЕНИЕ
Иногда проблема действительно в масштабе каталога – но далеко не всегда
Для крупных, быстро меняющихся магазинов важно, на какие URL поисковый робот расходует обход. Но магазин на несколько тысяч нормальных страниц не стоит автоматически лечить «краулинговым бюджетом».
Правильная цель
Не заставить Google обходить больше, а убрать бессмысленные URL и сделать важные страницы проще для обнаружения.
СЦЕНАРИЙ 3
«Просканирована, пока не проиндексирована» – это уже другой уровень проверки
Google уже посетил страницу. Здесь уже имеет смысл брать группу таких URL и искать общие признаки.
Насколько карточки действительно отличаются друг от друга?
Есть ли характеристики, цена, наличие, фото, варианты?
Есть ли отзывы, доставка, аналоги и другая самостоятельная ценность?
Насколько страница связана с каталогом внутренними ссылками?
Не превращайте это в «перепишем 5000 описаний ради уникальности»
Задача – понять, является ли каждая нужная карточка самостоятельной полезной поисковой страницей.
СЦЕНАРИЙ 4 · ДУБЛИ
Google может знать страницу – но считать основной другой URL
Один товар способен существовать сразу в нескольких адресах. Тогда поисковику приходится определить главную версию.
ОДИН ТОВАР
/product-123/
/catalog/product-123/
/brand/product-123/
/product-123/?color=black
Это уже не один сигнал – а три конфликтующих версии
Canonical, sitemap и внутренняя перелинковка должны логически поддерживать одну основную страницу.
ФИЛЬТРЫ – ОТДЕЛЬНАЯ ЗОНА РИСКА
Несколько параметров способны создать тысячи дополнительных URL
Некоторые фильтры полезны как самостоятельные посадочные страницы. Другие создают лишь технические комбинации, которые не нужно продвигать.
/catalog/?brand=x
/catalog/?brand=x&color=black
/catalog/?brand=x&color=black&size=m
/catalog/?brand=x&color=black&size=m&sort=price
Задача не в том, чтобы открыть или закрыть все фильтры
Нужно отделить реальные поисковые посадочные страницы от служебных комбинаций.
SITEMAP – НЕ КНОПКА «ИНДЕКСИРОВАТЬ»
URL находится в sitemap – но это ещё ничего не гарантирует
Карта сайта помогает обнаруживать важные страницы. Но она не заставляет Google сканировать или индексировать каждую из них.
Канонические товары и категории
Редиректы и 404
Страницы с noindex
Параметры и дубли
URL в sitemap, но canonical ведёт на другую страницу
ПРОВЕРЬТЕ ТЕХНИЧЕСКИЕ ПРИЧИНЫ
Иногда проблема индексации лежит не в контенте, а в одной директиве
Для важного неприндексированного URL сначала исключите базовые технические препятствия.
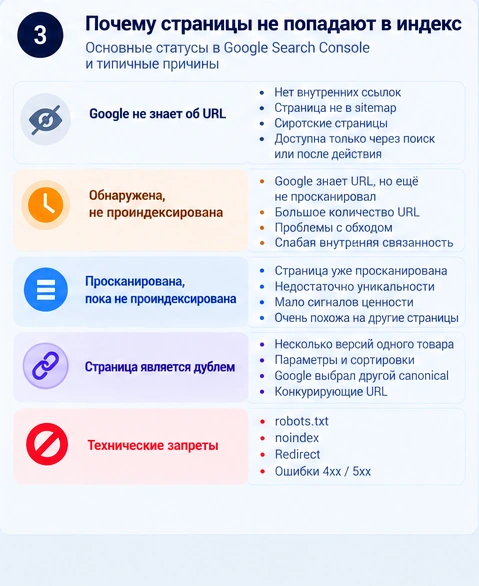
HTTP-ответ – 4xx, 5xx, 403
robots.txt
noindex
canonical на другую страницу
redirect
САМАЯ ПОЛЕЗНАЯ ПРОВЕРКА
Сравните CMS, sitemap и Search Console
Три набора URL быстро показывают, на каком уровне начинается потеря страниц.
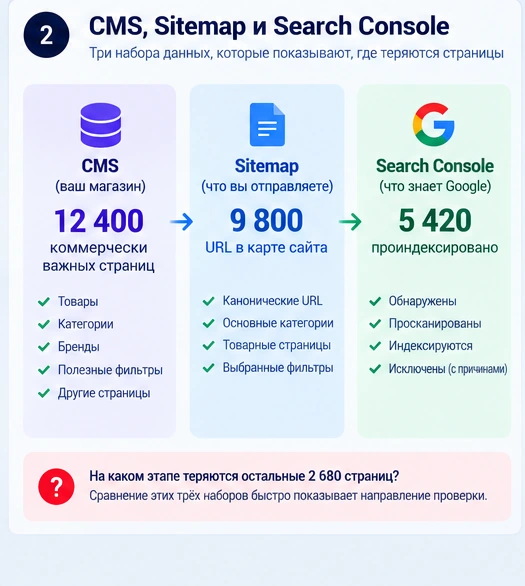
12 400
коммерчески важных страниц существует
9 800
URL сам магазин отправляет Google
5 420
страниц находятся в индексе
Три ситуации – три совершенно разных направления проверки
СИТУАЦИЯ 1
CMS – 12 000 → Sitemap – 7 000
Google здесь ещё ни при чём. Сначала выясняем, почему сайт сам не передаёт 5 000 нужных URL.
СИТУАЦИЯ 2
Sitemap – 8 000 → Google знает 5 500
Проверяем внутреннюю структуру, пагинацию, доступность URL и JavaScript.
СИТУАЦИЯ 3
Google знает 8 000 → индексирует 4 200
Обнаружение уже работает. Смотрим причины исключения, canonical, дубли и сами страницы.
НЕ СЧИТАЙТЕ ИНДЕКС ЧЕРЕЗ SITE:
Оператор site: полезен для проверки, но не для точного подсчёта страниц
site:example.com
Для системной оценки большого каталога используйте Search Console и собственный список коммерчески важных URL.
ПОРЯДОК ИСПРАВЛЕНИЙ
Что проверять первым
robots, noindex, ошибки, redirects, canonical
Сиротские страницы, пагинация, sitemap и ссылки
Параметры, сортировки, фильтры и дубли
Только теперь анализируем уже просканированные карточки
ЧЕК-ЛИСТ
Что проверить владельцу интернет-магазина
Определите количество действительно нужных SEO-страниц
Сравните CMS и sitemap
Сравните sitemap и Search Console
Разделите URL по статусам индексирования
Проверьте внутреннюю перелинковку и пагинацию
Найдите сиротские страницы
Проверьте robots.txt, noindex и HTTP-ответы
Проверьте canonical
Оцените количество фильтров и параметров
Возьмите выборку просканированных, но не проиндексированных URL
Проверьте JavaScript-каталог
Не отправляйте тысячи URL вручную – устраните системную причину
ИНДЕКС ≠ ТРАФИК
Страница может находиться в Google и всё равно не получать посетителей
Индексация лишь даёт техническую возможность участвовать в поиске. Дальше остаются спрос, релевантность, оптимизация, конкуренция и позиции.
ДВА РАЗНЫХ ВОПРОСА
1. Страница находится в индексе?
2. Страница способна конкурировать и получать поисковый спрос?
НЕ ЛЕЧИТЕ СИСТЕМУ РУЧНЫМ ПЕРЕОБХОДОМ
Кнопка «Запросить индексирование» не исправит архитектуру магазина
Для отдельных новых или исправленных страниц ручная отправка полезна. Но если проблема затрагивает сотни или тысячи URL, нужно исправлять сам механизм обнаружения и индексирования.
Индексация большого каталога должна быть свойством архитектуры
Новые товары должны корректно обнаруживаться и обрабатываться без постоянной ручной отправки.
ГЛАВНЫЙ ВЫВОД
«Google индексирует только половину магазина» – слишком общая формулировка
Проблему нужно превратить в конкретный статус и конкретную группу URL.
СЛИШКОМ ОБЩО
«Google не индексирует товары»
УЖЕ МОЖНО ДИАГНОСТИРОВАТЬ
«Из 6500 нужных карточек Google не обнаружил 1800 URL»
Частые вопросы об индексации интернет-магазина
Почему Google не индексирует все товары интернет-магазина?
Google может не обнаружить URL, ещё не просканировать его, встретить технический запрет, выбрать другую canonical-страницу или после сканирования пока не включить страницу в индекс.
Должны ли все товары интернет-магазина индексироваться?
Не каждый существующий URL. Важно, чтобы индексировались канонические коммерчески полезные страницы, а не сортировки, служебные параметры и дубли.
Что означает «Обнаружена, не проиндексирована»?
Google уже знает URL, но пока его не просканировал. Сам статус не означает, что поисковик уже оценил содержимое страницы как плохое.
Что означает «Просканирована, пока не проиндексирована»?
Google посетил URL, но пока не включил его в индекс. Нужно анализировать группу таких страниц, а не делать вывод по одному адресу.
Поможет ли добавление страницы в sitemap?
Sitemap помогает обнаруживать URL, но сам по себе не гарантирует ни сканирование, ни индексирование.
Нужно ли вручную отправлять все карточки на индексирование?
Нет. Для массовой проблемы нужно исправить системную причину – структуру, sitemap, ссылки, canonical, фильтры или технические настройки.
Почему страница есть в индексе, но трафика нет?
Индексация только допускает страницу к участию в поиске. Для трафика ещё нужны релевантность, спрос, оптимизация и достаточные позиции.
ЧИТАЙТЕ ТАКЖЕ
Что проверить после диагностики индексации
Дальнейшая работа зависит от того, находится ли проблема в структуре каталога, техническом SEO или продвижении уже индексируемых страниц.
01 · ЕСЛИ ИНДЕКС ЕСТЬ, А ЗАКАЗОВ НЕТ
Есть посетители, но нет заказов – почему интернет-магазин не продаёт →
Разбираем уже не индексирование, а коммерческую воронку магазина.
02 · КОМПЛЕКСНАЯ РАБОТА С КАТАЛОГОМ
SEO для интернет-магазина – категории, фильтры, карточки и продажи →
Для системной работы со структурой, посадочными страницами и товарным спросом.
03 · ЕСЛИ НУЖНО НАЙТИ СИСТЕМНУЮ ПРИЧИНУ
Аудит сайта →
Проверка технических ограничений, структуры и проблем индексирования.
НУЖНО НАЙТИ ТОЧКУ ПОТЕРИ URL?
В CMS тысячи страниц, а Google видит только часть?
Сравним каталог, sitemap и данные Search Console, разделим URL по причинам исключения и определим, что действительно мешает нужным страницам попадать в индекс.
Обсудить проблему индексации →