Как аудит 262 страниц помог отделить единичные замечания от системных проблем в индексировании, метатегах, контенте, перелинковке и шаблонах сайта.
SEO audit case
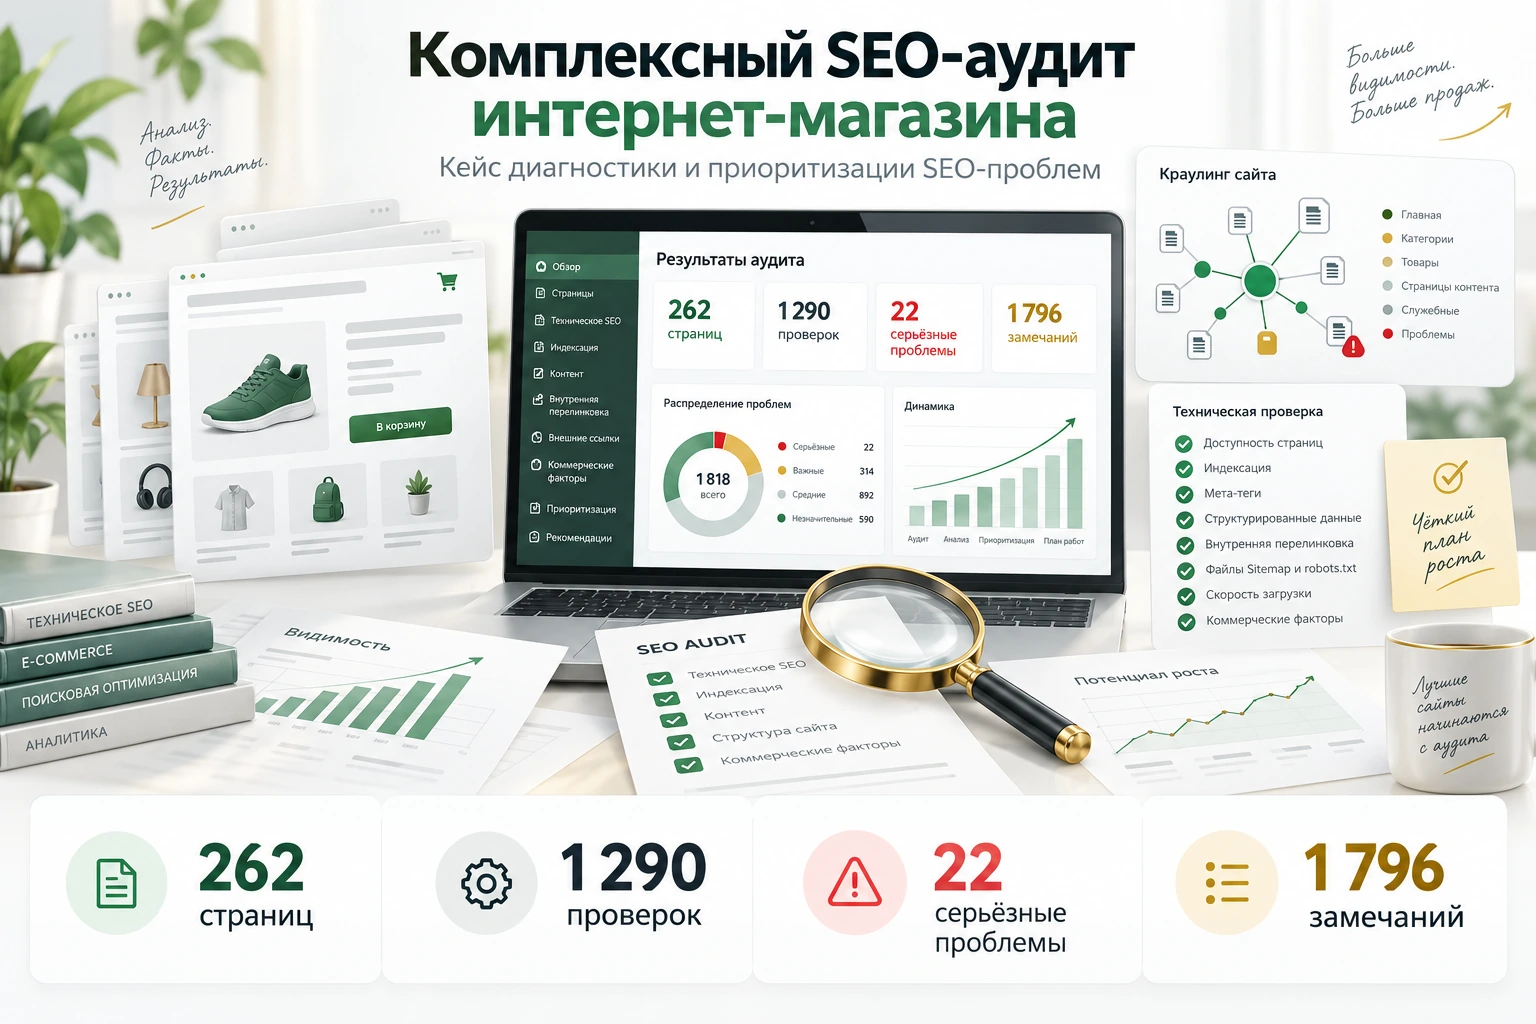
262 страницы – но проблема была не в количестве URL
Интернет-магазин состоял из категорий, карточек товаров, страниц производителей, информационных материалов, архивов и служебных URL. Поэтому проверка нескольких основных посадочных не могла показать реальное состояние проекта.
просканированные страницы
выполненных проверок
серьёзные проблемы
важных замечаний
Главная задача состояла не в том, чтобы получить максимально длинный список ошибок, а определить, какие отклонения единичны, а какие воспроизводятся системно и требуют исправления на уровне шаблонов, архитектуры или логики сайта.
Что именно нужно было проверить
Для крупного интернет-магазина недостаточно посмотреть только Title, robots.txt или скорость загрузки. Нужно увидеть SEO-систему целиком.
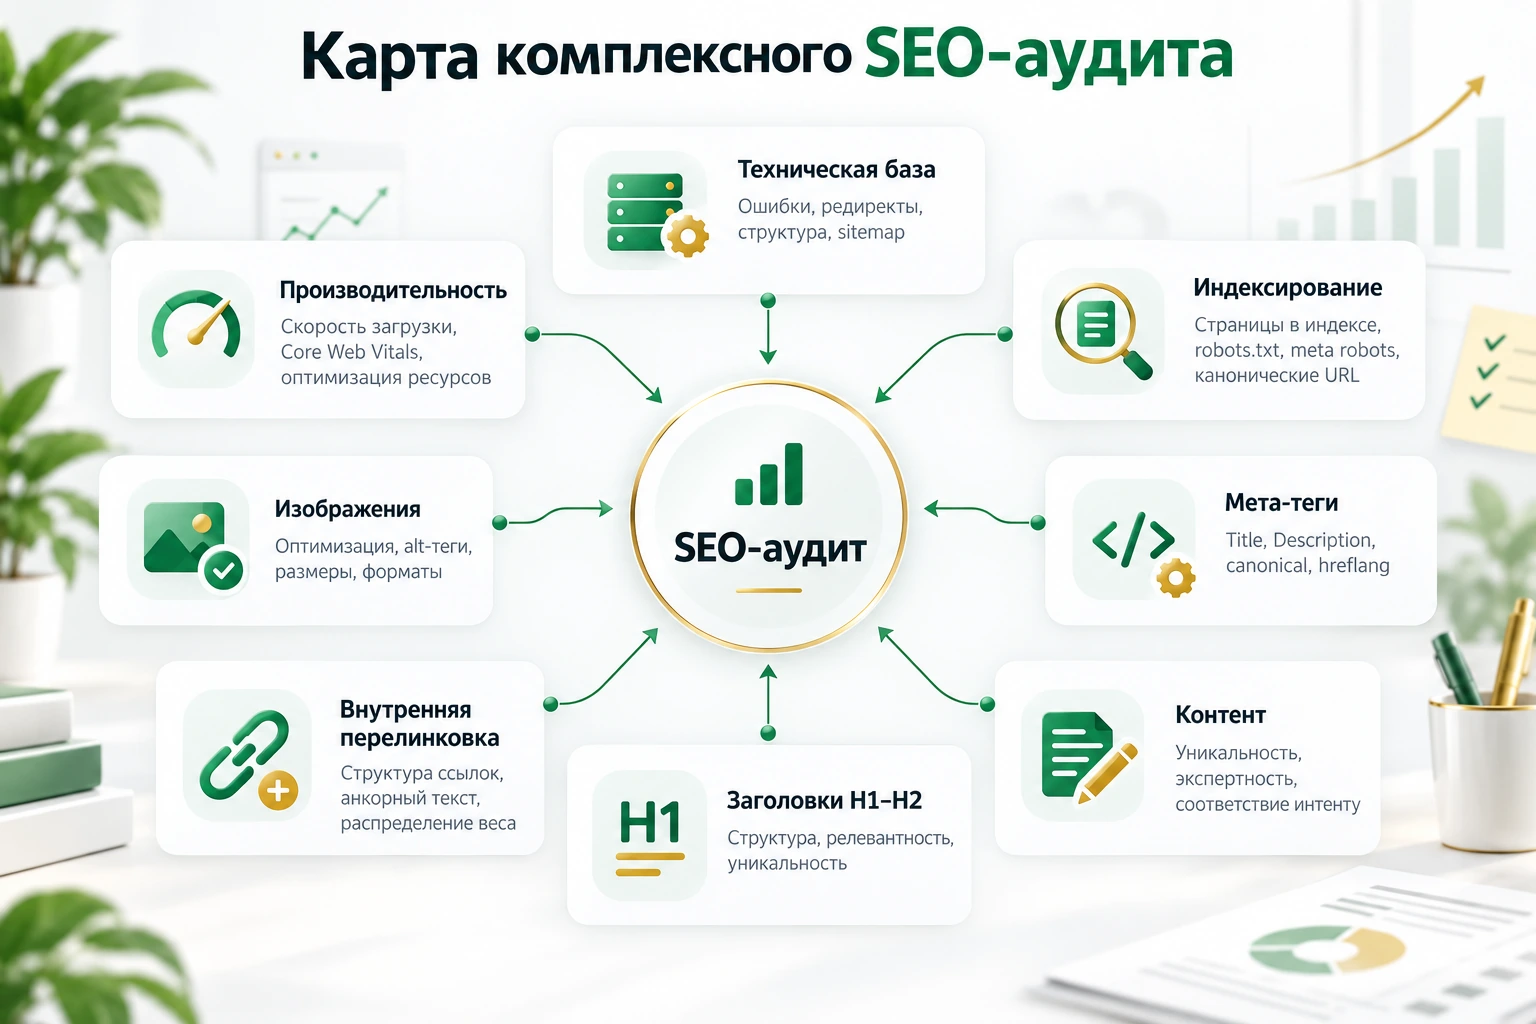
URL, HTTPS, robots.txt, Sitemap и служебные элементы.
Noindex, canonical, alternate и доступность документов.
Title, Description, H1, H2 и структура контента.
Внутренние ссылки, анкоры, изображения и шаблоны.
8 направлений комплексного SEO-аудита
Проверка была разделена на технический слой, индексирование, метатеги, контент, заголовки, внутреннюю перелинковку, изображения и производительность. Такой подход позволяет увидеть не отдельные симптомы, а взаимосвязь проблем.
Индексирование – canonical нужно проверять по смыслу, а не по факту наличия
На проверенных URL был обнаружен один документ с meta noindex, 245 страниц с rel="canonical" и 20 страниц, использующих одинаковый canonical URL.
страница с noindex
страниц с canonical
URL с одинаковым canonical
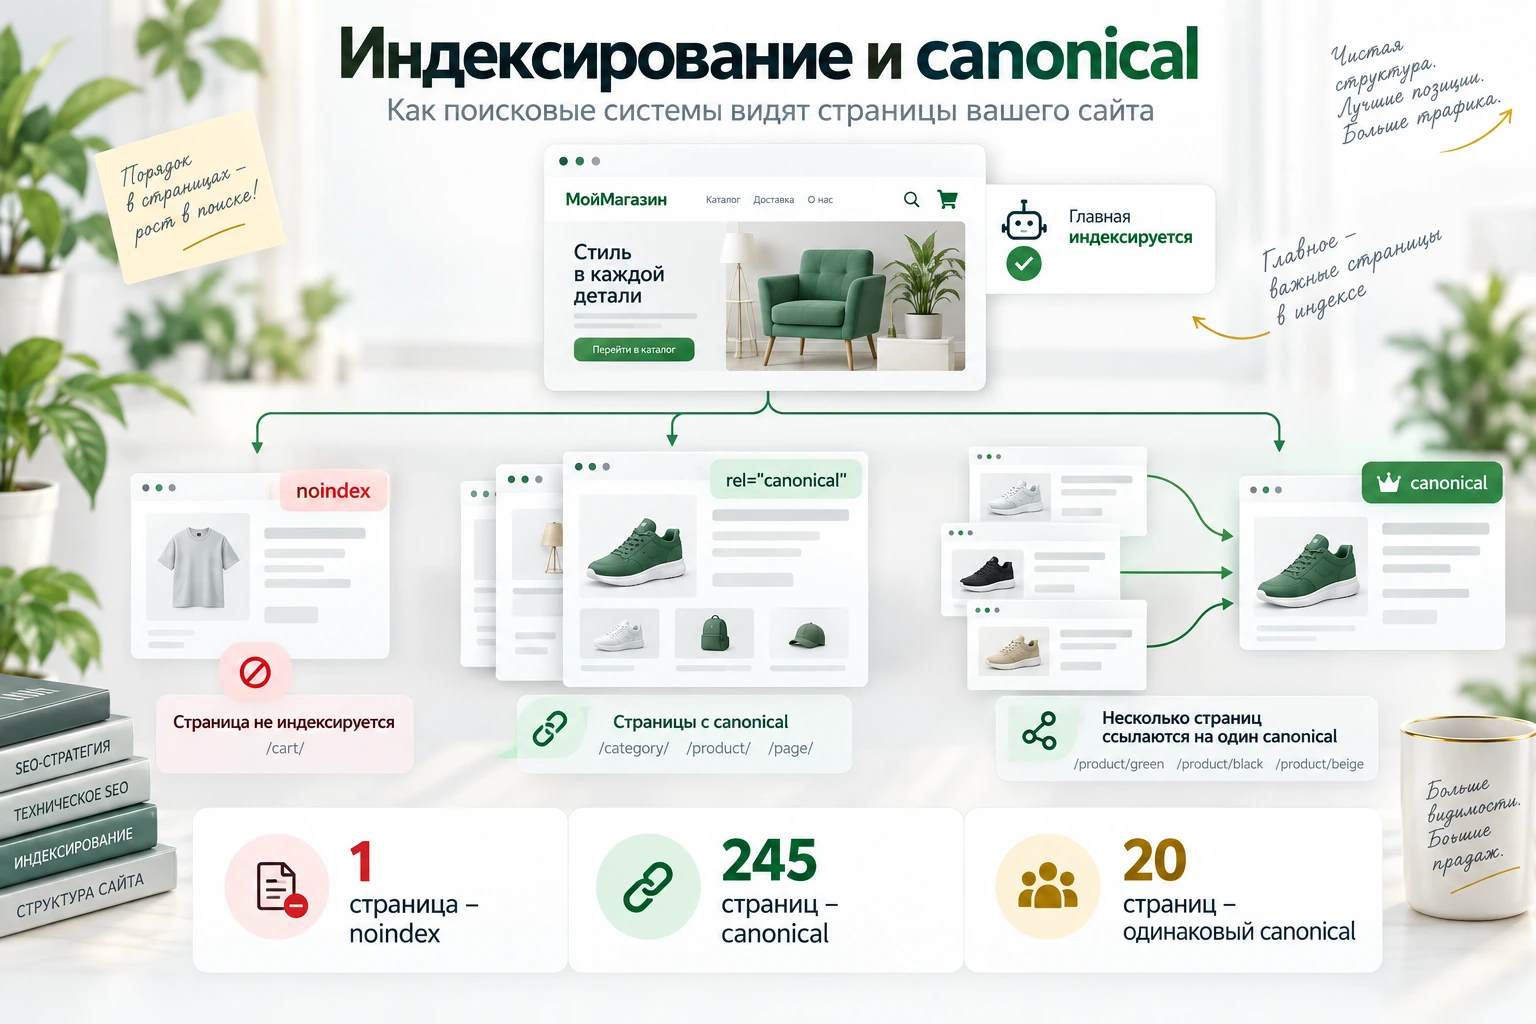
Само наличие canonical ещё не подтверждает корректность настройки. Нужно проверить, на какой документ он указывает, соответствует ли это назначению страницы и не исключается ли из поиска самостоятельный URL, который должен индексироваться.
URL-структура – 10 адресов потребовали отдельного анализа
В выборке было найдено 10 страниц с чрезмерно длинными URL. Некоторые адреса представляли собой большие транслитерированные конструкции, сформированные из длинных названий категорий и статей.
Длина URL сама по себе не является причиной переписывать структуру сайта. Вопрос в другом – не создаёт ли механизм формирования адресов дубли, сложность сопровождения, ошибки перелинковки и ненужные варианты страниц.
Метатеги – проблема была уже на уровне шаблонов
Title и Description присутствовали на сайте, но их формирование требовало системной доработки.
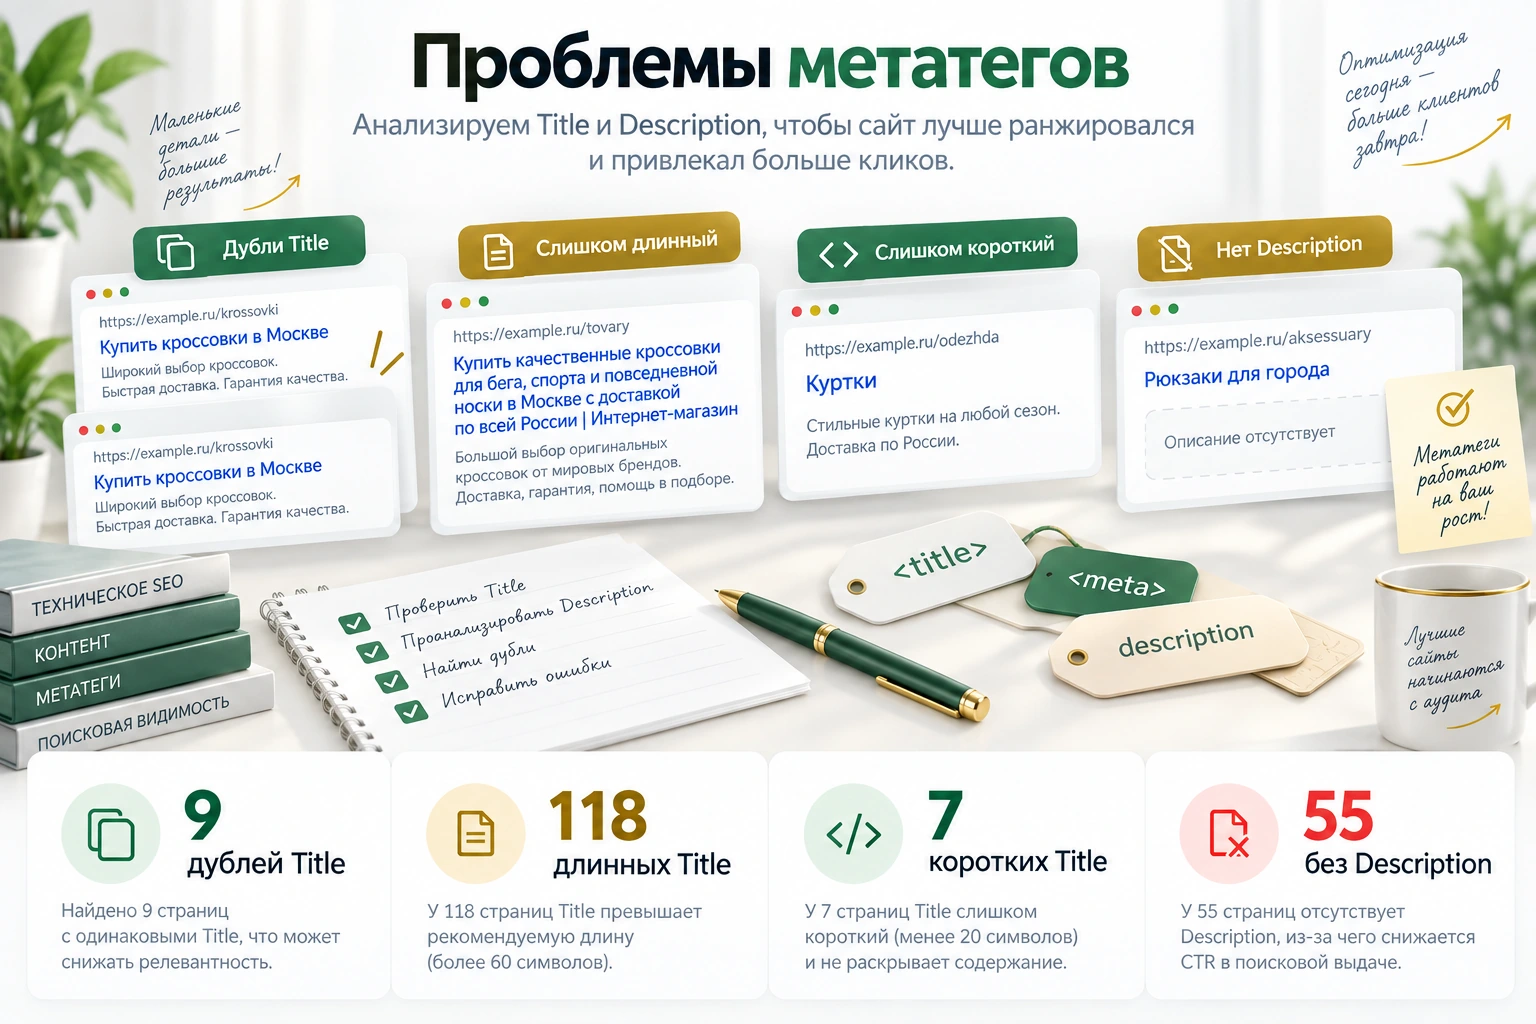
дублей Title
длинных Title по критериям отчёта
коротких Title
страниц без Description
118 проблемных Title – это уже не 118 отдельных задач
Когда одинаковое отклонение встречается на большой группе документов, сначала нужно искать общую формулу генерации метатега.
Вместо ручного редактирования каждой карточки эффективнее сначала изменить правило генерации и только после этого перепроверить всю группу URL.
Контент и заголовки – проблемы отличались по масштабу
Проверка структуры содержимого показала несколько разных групп отклонений: от отдельных страниц с небольшим количеством текста до повторяющихся H1 и отсутствующих H2.
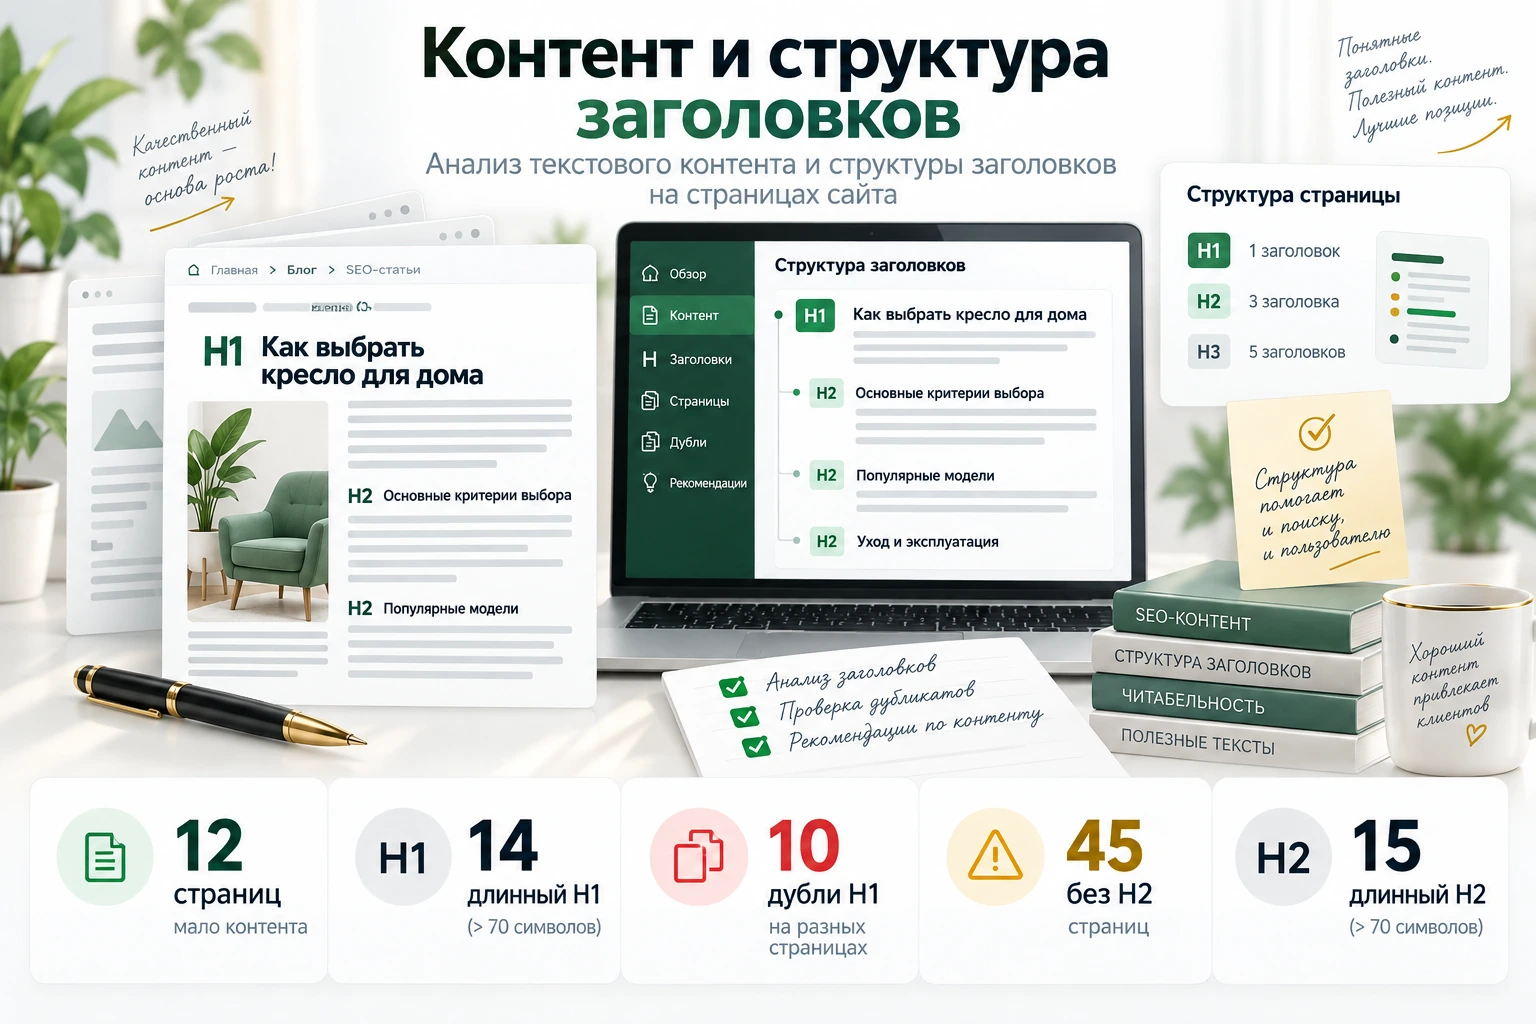
страниц с малым объёмом
длинных H1
дублирующихся H1
страниц без H2
длинных H2
Почему дубли H1 требуют проверки интента
Одинаковый H1 может встречаться на категории, карточке товара, информационной странице или архиве. В таком случае проблема потенциально глубже самого заголовка – разные URL могут конкурировать за один поисковый интент.
Не «как переписать 10 H1», а «почему разные документы получили одинаковую смысловую роль и действительно ли все они должны существовать как самостоятельные поисковые страницы?»
Количество слов само по себе не делает страницу качественной
Исходный аудит выполнен в 2018 году, когда SEO-инструменты часто использовали формальные минимумы текста. Сегодня универсальное требование «не менее 400 слов» применять некорректно.
Характеристики, применение, варианты, доставка, отзывы.
Ассортимент, фильтры, критерии выбора, коммерческая информация.
Полный ответ на информационный интент и связанные вопросы.
637 ссылок без анкоров и 865 изображений без ALT
Эти две группы стали одним из самых показательных результатов аудита. Такие числа уже нельзя воспринимать как случайный набор отдельных ошибок.
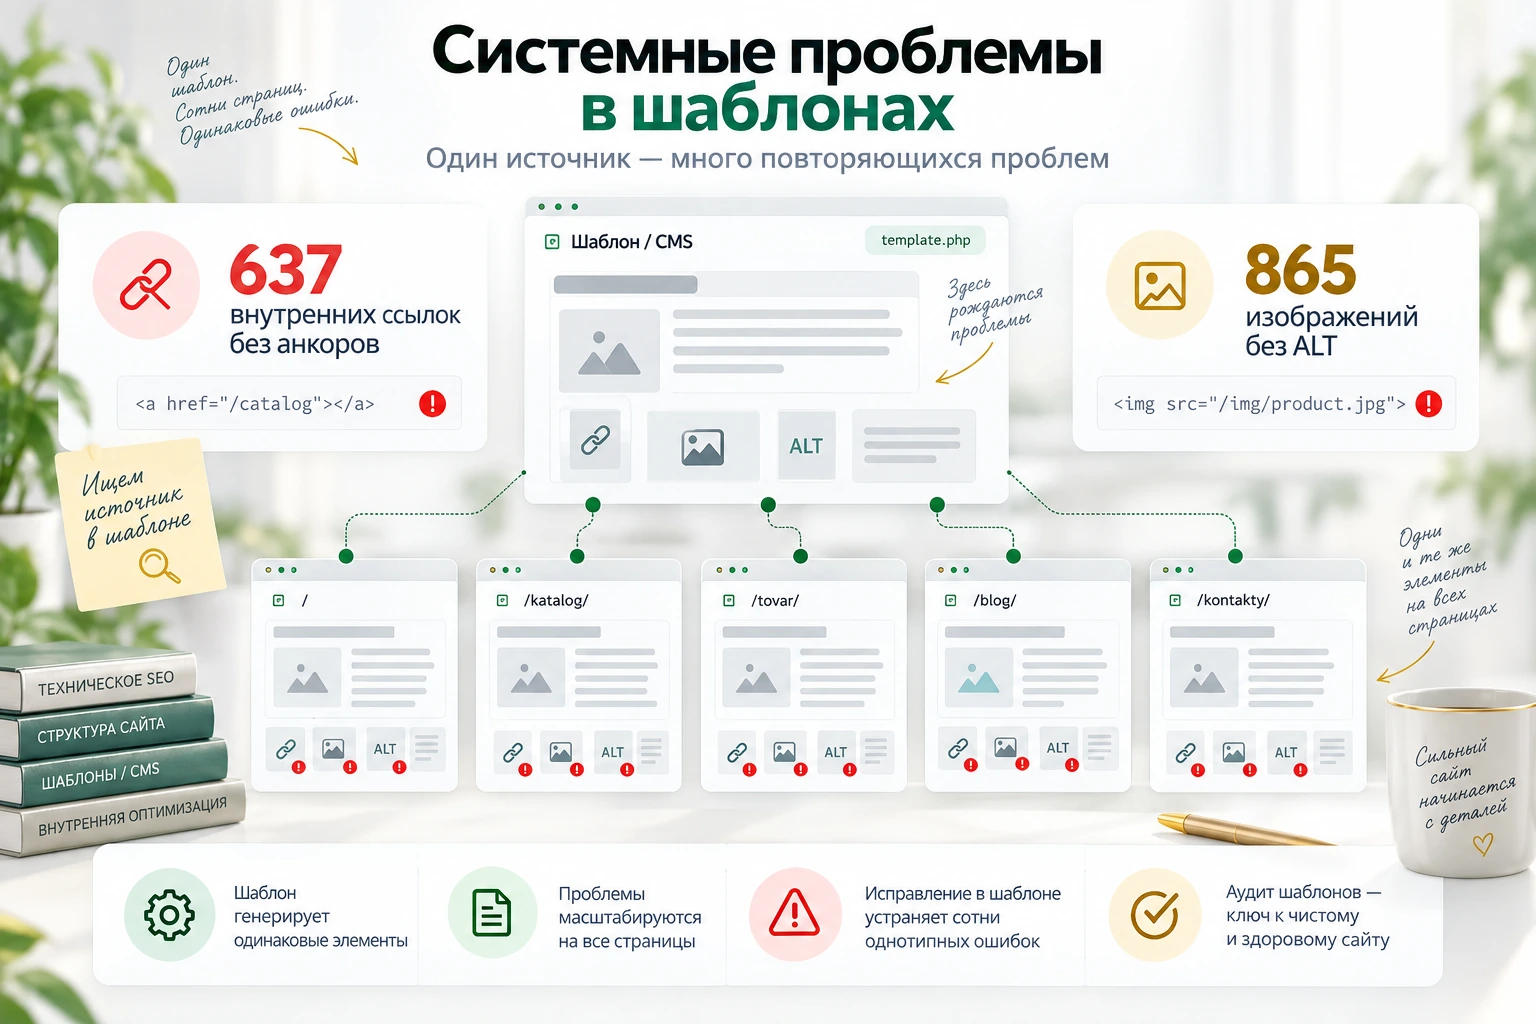
внутренних ссылок с отсутствующим анкором
изображений без ALT
Как отличить системную проблему от сотен отдельных ошибок
– понять, какие URL имеют одинаковое отклонение.
– шаблон, модуль, меню, карточку, изображение-ссылку или генератор метатегов.
– внести изменение один раз на системном уровне.
– повторно просканировать весь затронутый сегмент.
Производительность – аудит проводился ещё до эпохи Core Web Vitals
В отчёте было зафиксировано среднее время около 875 ms. Среди рекомендаций присутствовали оптимизация изображений, сокращение времени ответа сервера, кеширование, сжатие и уменьшение блокирующего CSS и JavaScript.
Server response, CSS/JS, cache, compression, изображения и размер ресурсов.
LCP, INP, CLS, Lighthouse, Chrome UX Report и данные Core Web Vitals.
1 796 замечаний не означают 1 796 независимых задач
Автоматический инструмент способен показать тысячи строк. Работа SEO-специалиста начинается там, где эти строки нужно объединить в причины, определить влияние и поставить задачи в правильном порядке.
могут происходить из нескольких общих шаблонов изображений.
могут генерироваться одним элементом интерфейса.
могут зависеть от одной формулы генерации.
Как расставить приоритеты после SEO-аудита
| Уровень | Что относится | Что делать |
|---|---|---|
| Критический | Noindex, canonical, доступность важных URL | Проверять и исправлять в первую очередь |
| Высокий | Дубли H1, Title, шаблонные ошибки перелинковки | Искать системный источник |
| Средний | Description, H2, значимые ALT, сложные URL | Исправлять после критичных групп |
| Проверочный | Формальные лимиты длины и объёма | Оценивать по контексту, а не автоматически |
Что из SEO-аудита 2018 года сегодня оценивалось бы иначе
Исходный отчёт отражает практику своего периода. Фактические данные аудита сохраняют ценность, но часть формальных рекомендаций сегодня требует другой интерпретации.
| Подход старого отчёта | Как оцениваем сегодня |
|---|---|
| Фиксированный лимит Title | Интент, смысл, уникальность и отображение сниппета |
| Минимум 400 слов | Достаточность информации для конкретного типа страницы |
| Жёсткий лимит ссылок | Назначение, архитектура и полезность ссылок |
| Закрывать внешние ссылки nofollow | Атрибут выбирается по характеру конкретной ссылки |
| Meta Keywords | Не используется как значимый фактор Google SEO |
| PageSpeed старого формата | Дополняется LCP, INP, CLS и полевыми данными |
Клиент получил не список красных строк, а карту состояния сайта
Определены проблемные группы страниц и конкретные URL.
Отделены единичные ошибки от повторяющихся шаблонных проблем.
Понятно, какие группы требуют первоочередной работы.
Выводы можно переводить в задачи для SEO, разработки и контента.
Чего этот кейс не доказывает
Исходный аудит фиксирует состояние сайта в момент проведения проверки. В материалах нет подтверждённых данных о последующем росте органического трафика, позиций, конверсии или продаж после внедрения рекомендаций.
Поэтому в кейсе не используются вымышленные результаты. Его ценность – в глубине диагностики, выявлении системных причин и превращении большого массива технических данных в понятную структуру задач.
Формула полезного SEO-аудита
обнаружить проблему
определить причину
оценить масштаб
определить порядок
реализовать решение
повторить аудит
Частые вопросы о комплексном SEO-аудите
Технический аудит фокусируется на crawling, indexability, HTTP, canonical, robots.txt и производительности. Комплексный дополнительно рассматривает метатеги, контент, структуру заголовков, перелинковку и другие on-page факторы.
Нет. Сначала используется краулинг и группировка проблем, а затем вручную анализируются типовые представители каждой группы и источник повторяющегося отклонения.
Нет. Сервис показывает сигналы, но не всегда может определить назначение страницы, бизнес-ценность URL, поисковый интент и реальный приоритет исправления.
Нет. Часть отклонений является критичной, часть имеет средний приоритет, а некоторые требуют лишь проверки в контексте конкретного сайта.
После редизайна, миграции, смены CMS, изменения структуры URL, расширения каталога, внедрения фильтров или заметного падения органического трафика.
Полезно по теме
Нужен SEO-аудит, который покажет не только ошибки, но и их причины?
Если сайт содержит сотни или тысячи страниц, задача аудита – определить, что действительно мешает продвижению, какие URL затронуты и что необходимо исправлять в первую очередь.